V100 SXM2 雙卡首次亮相
2025最划算的AI顯卡
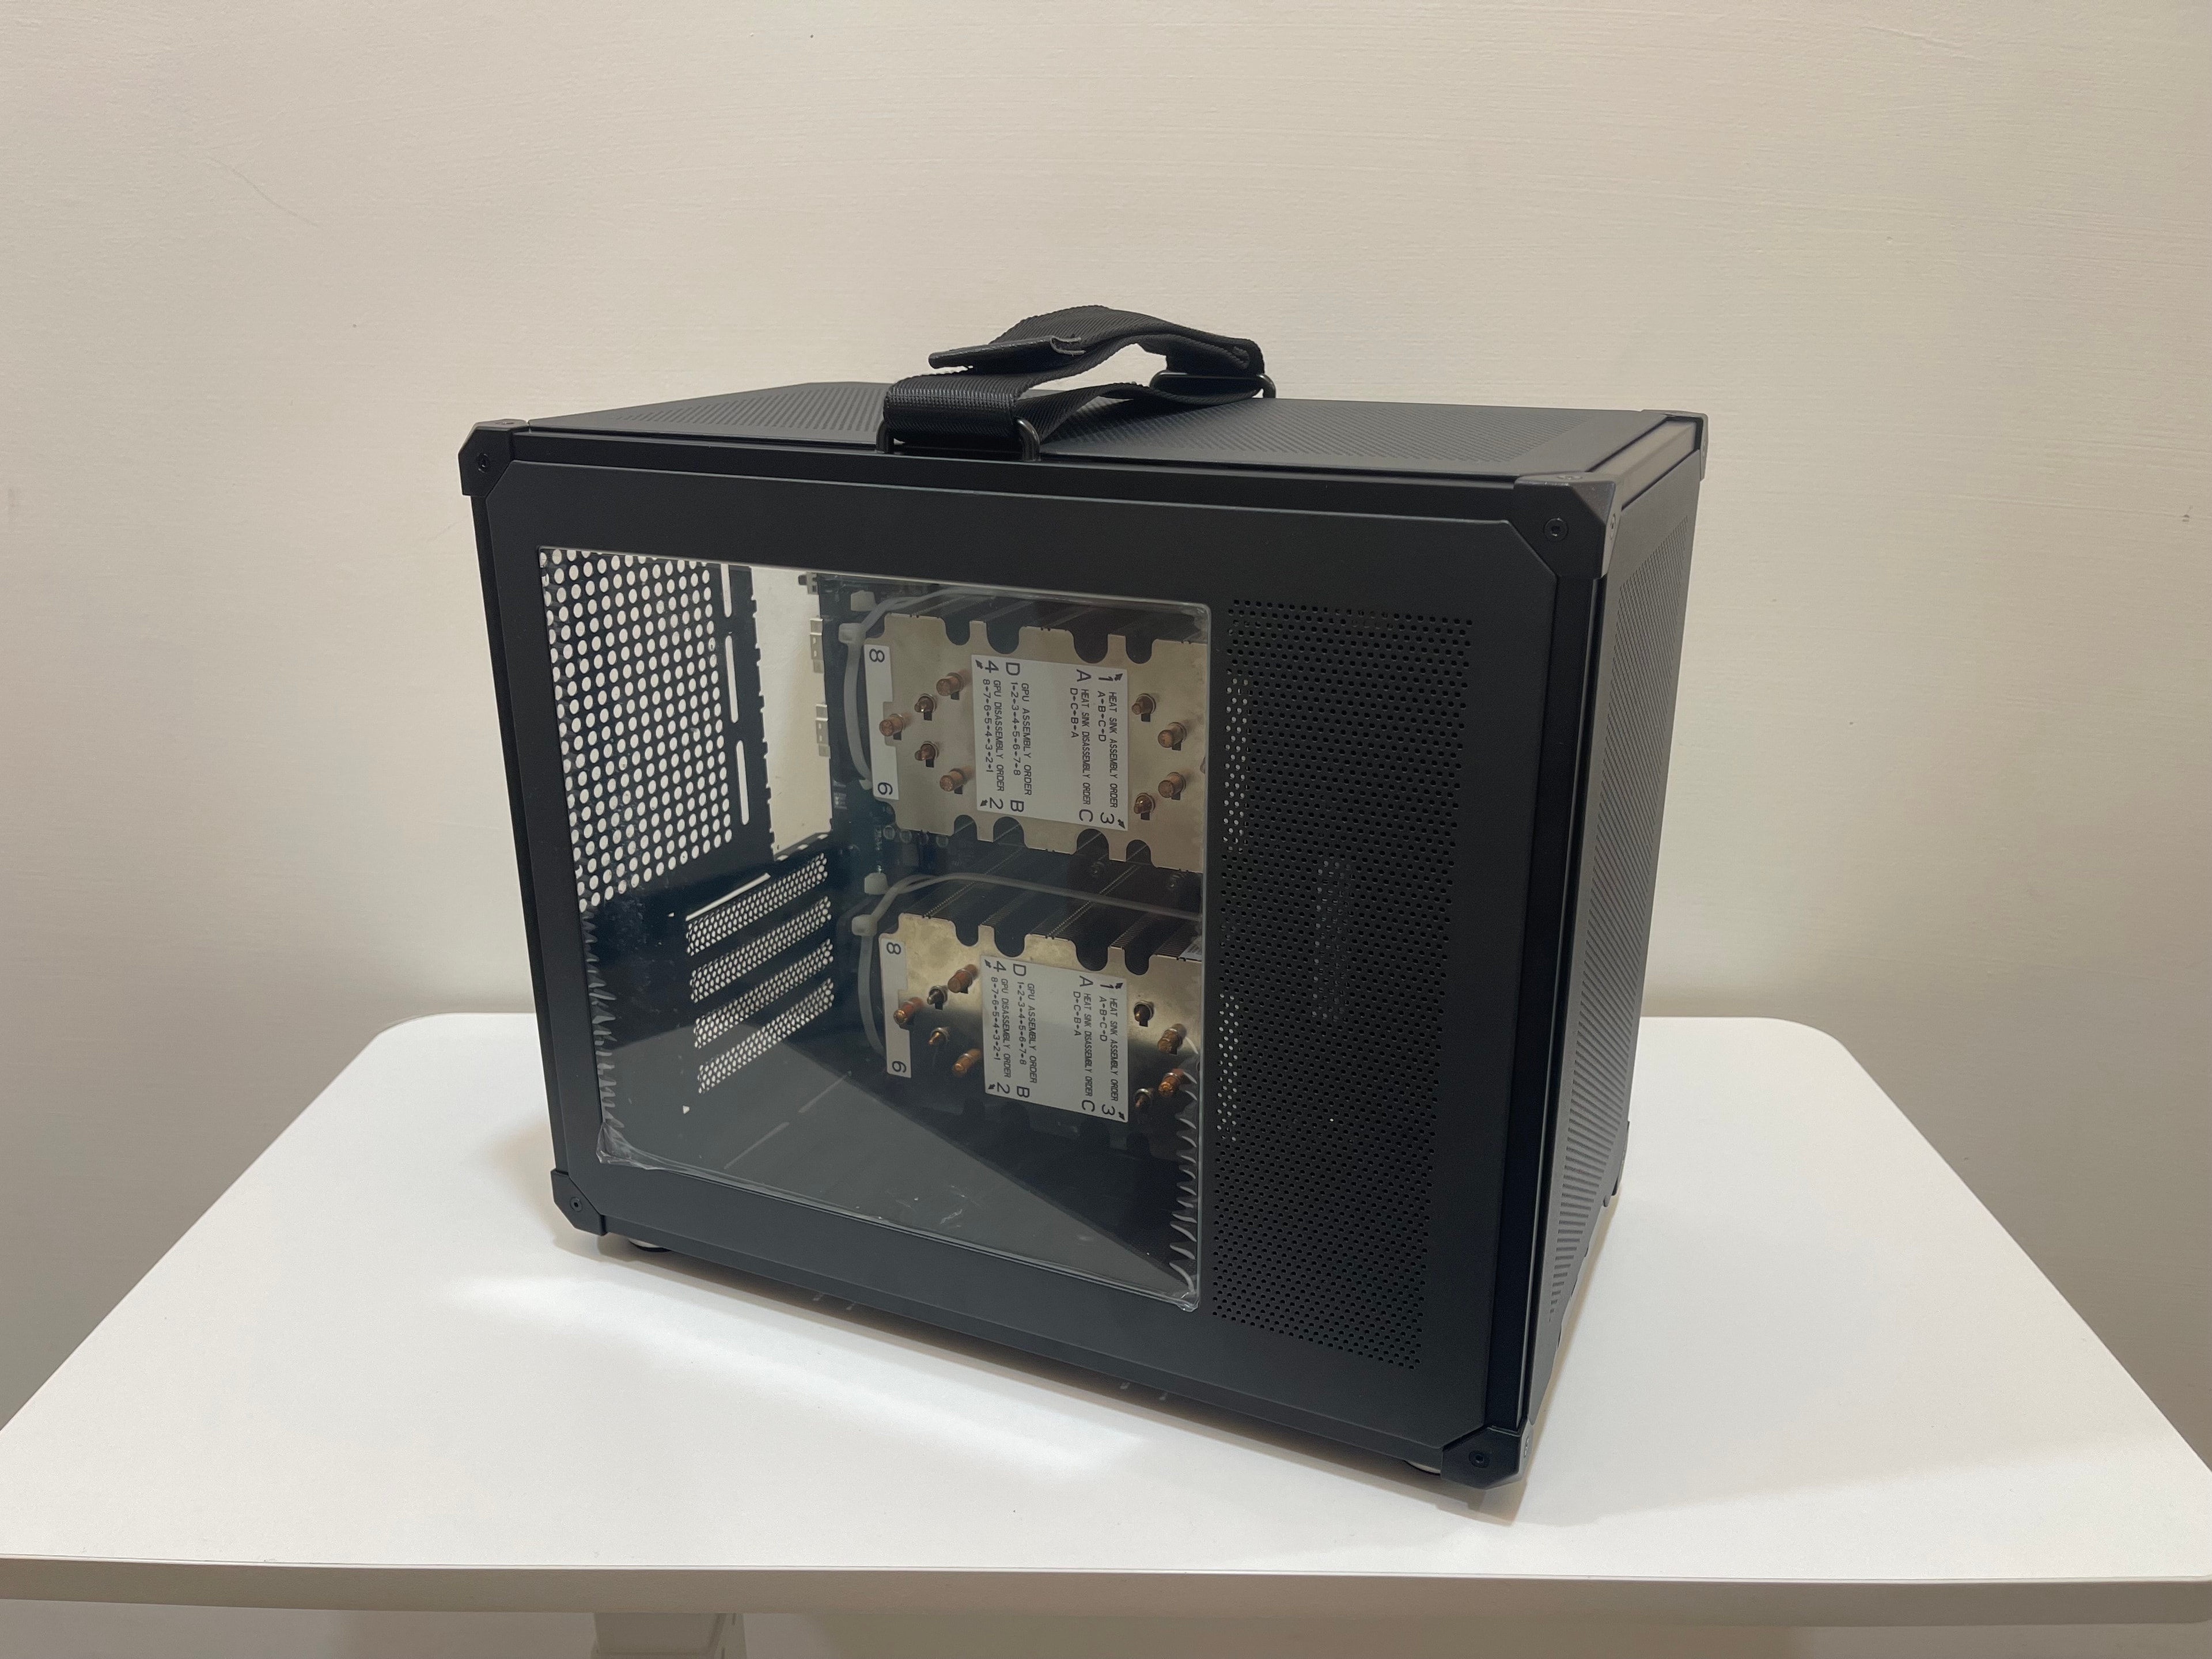
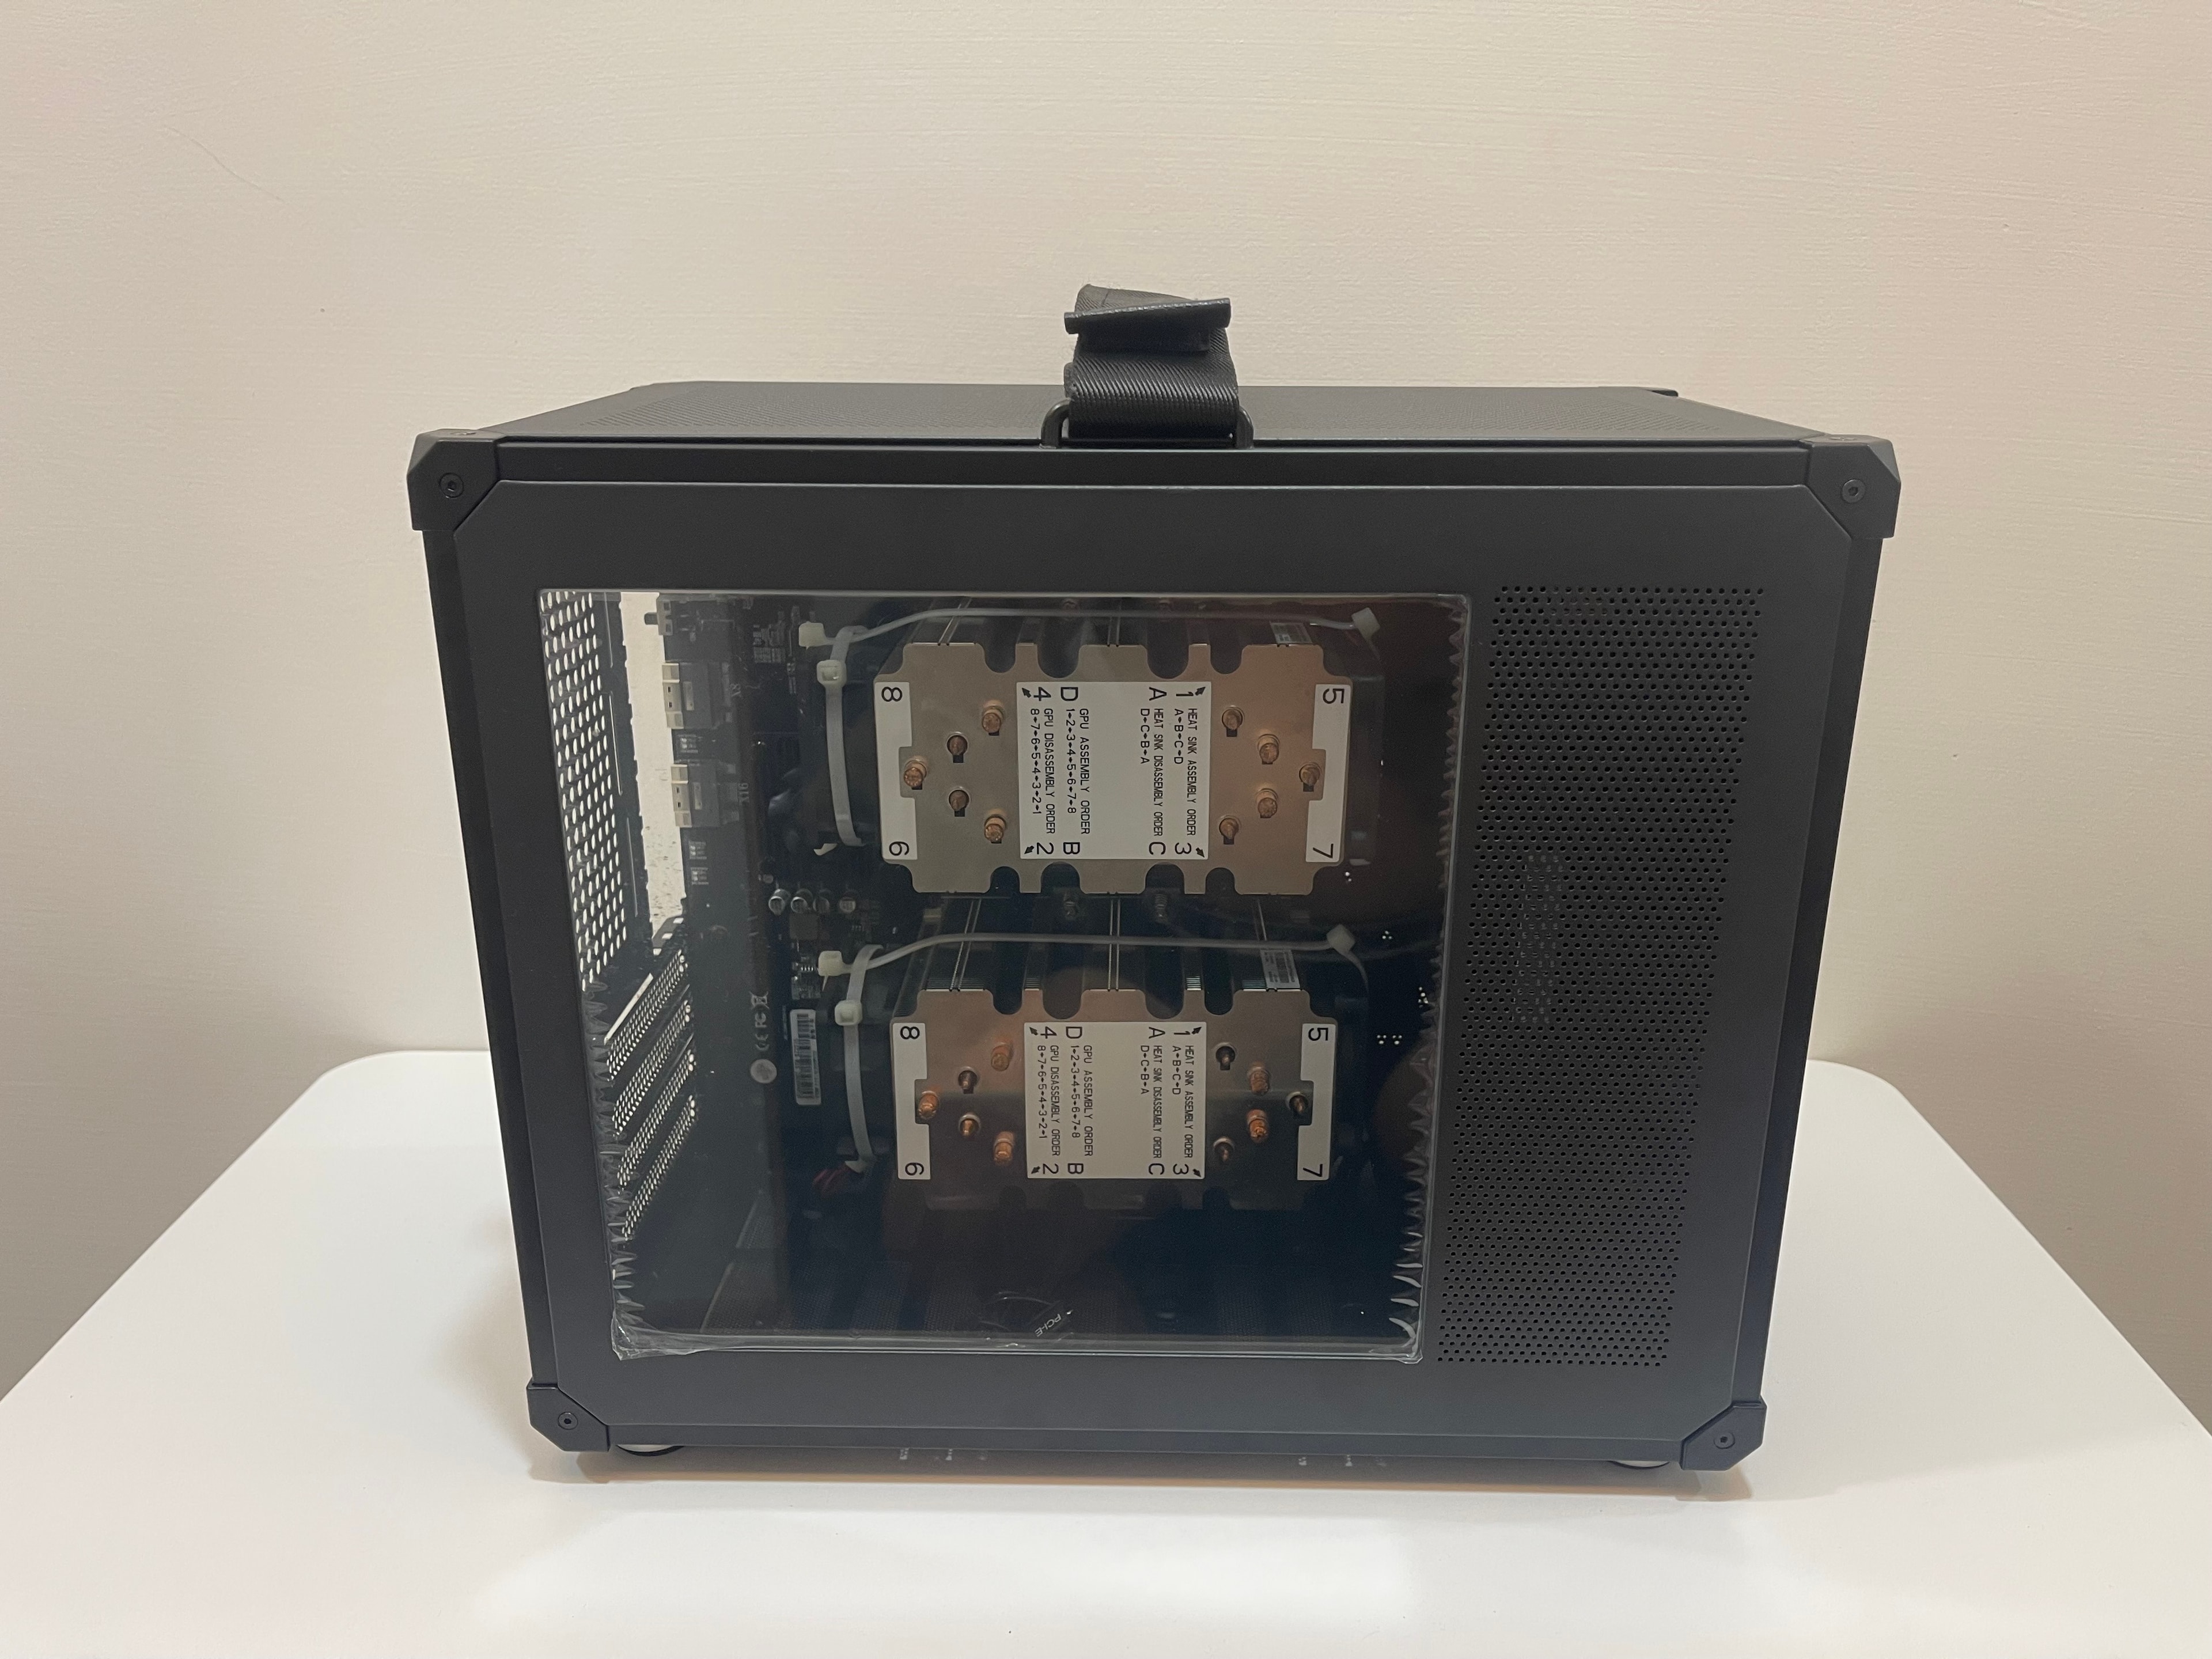
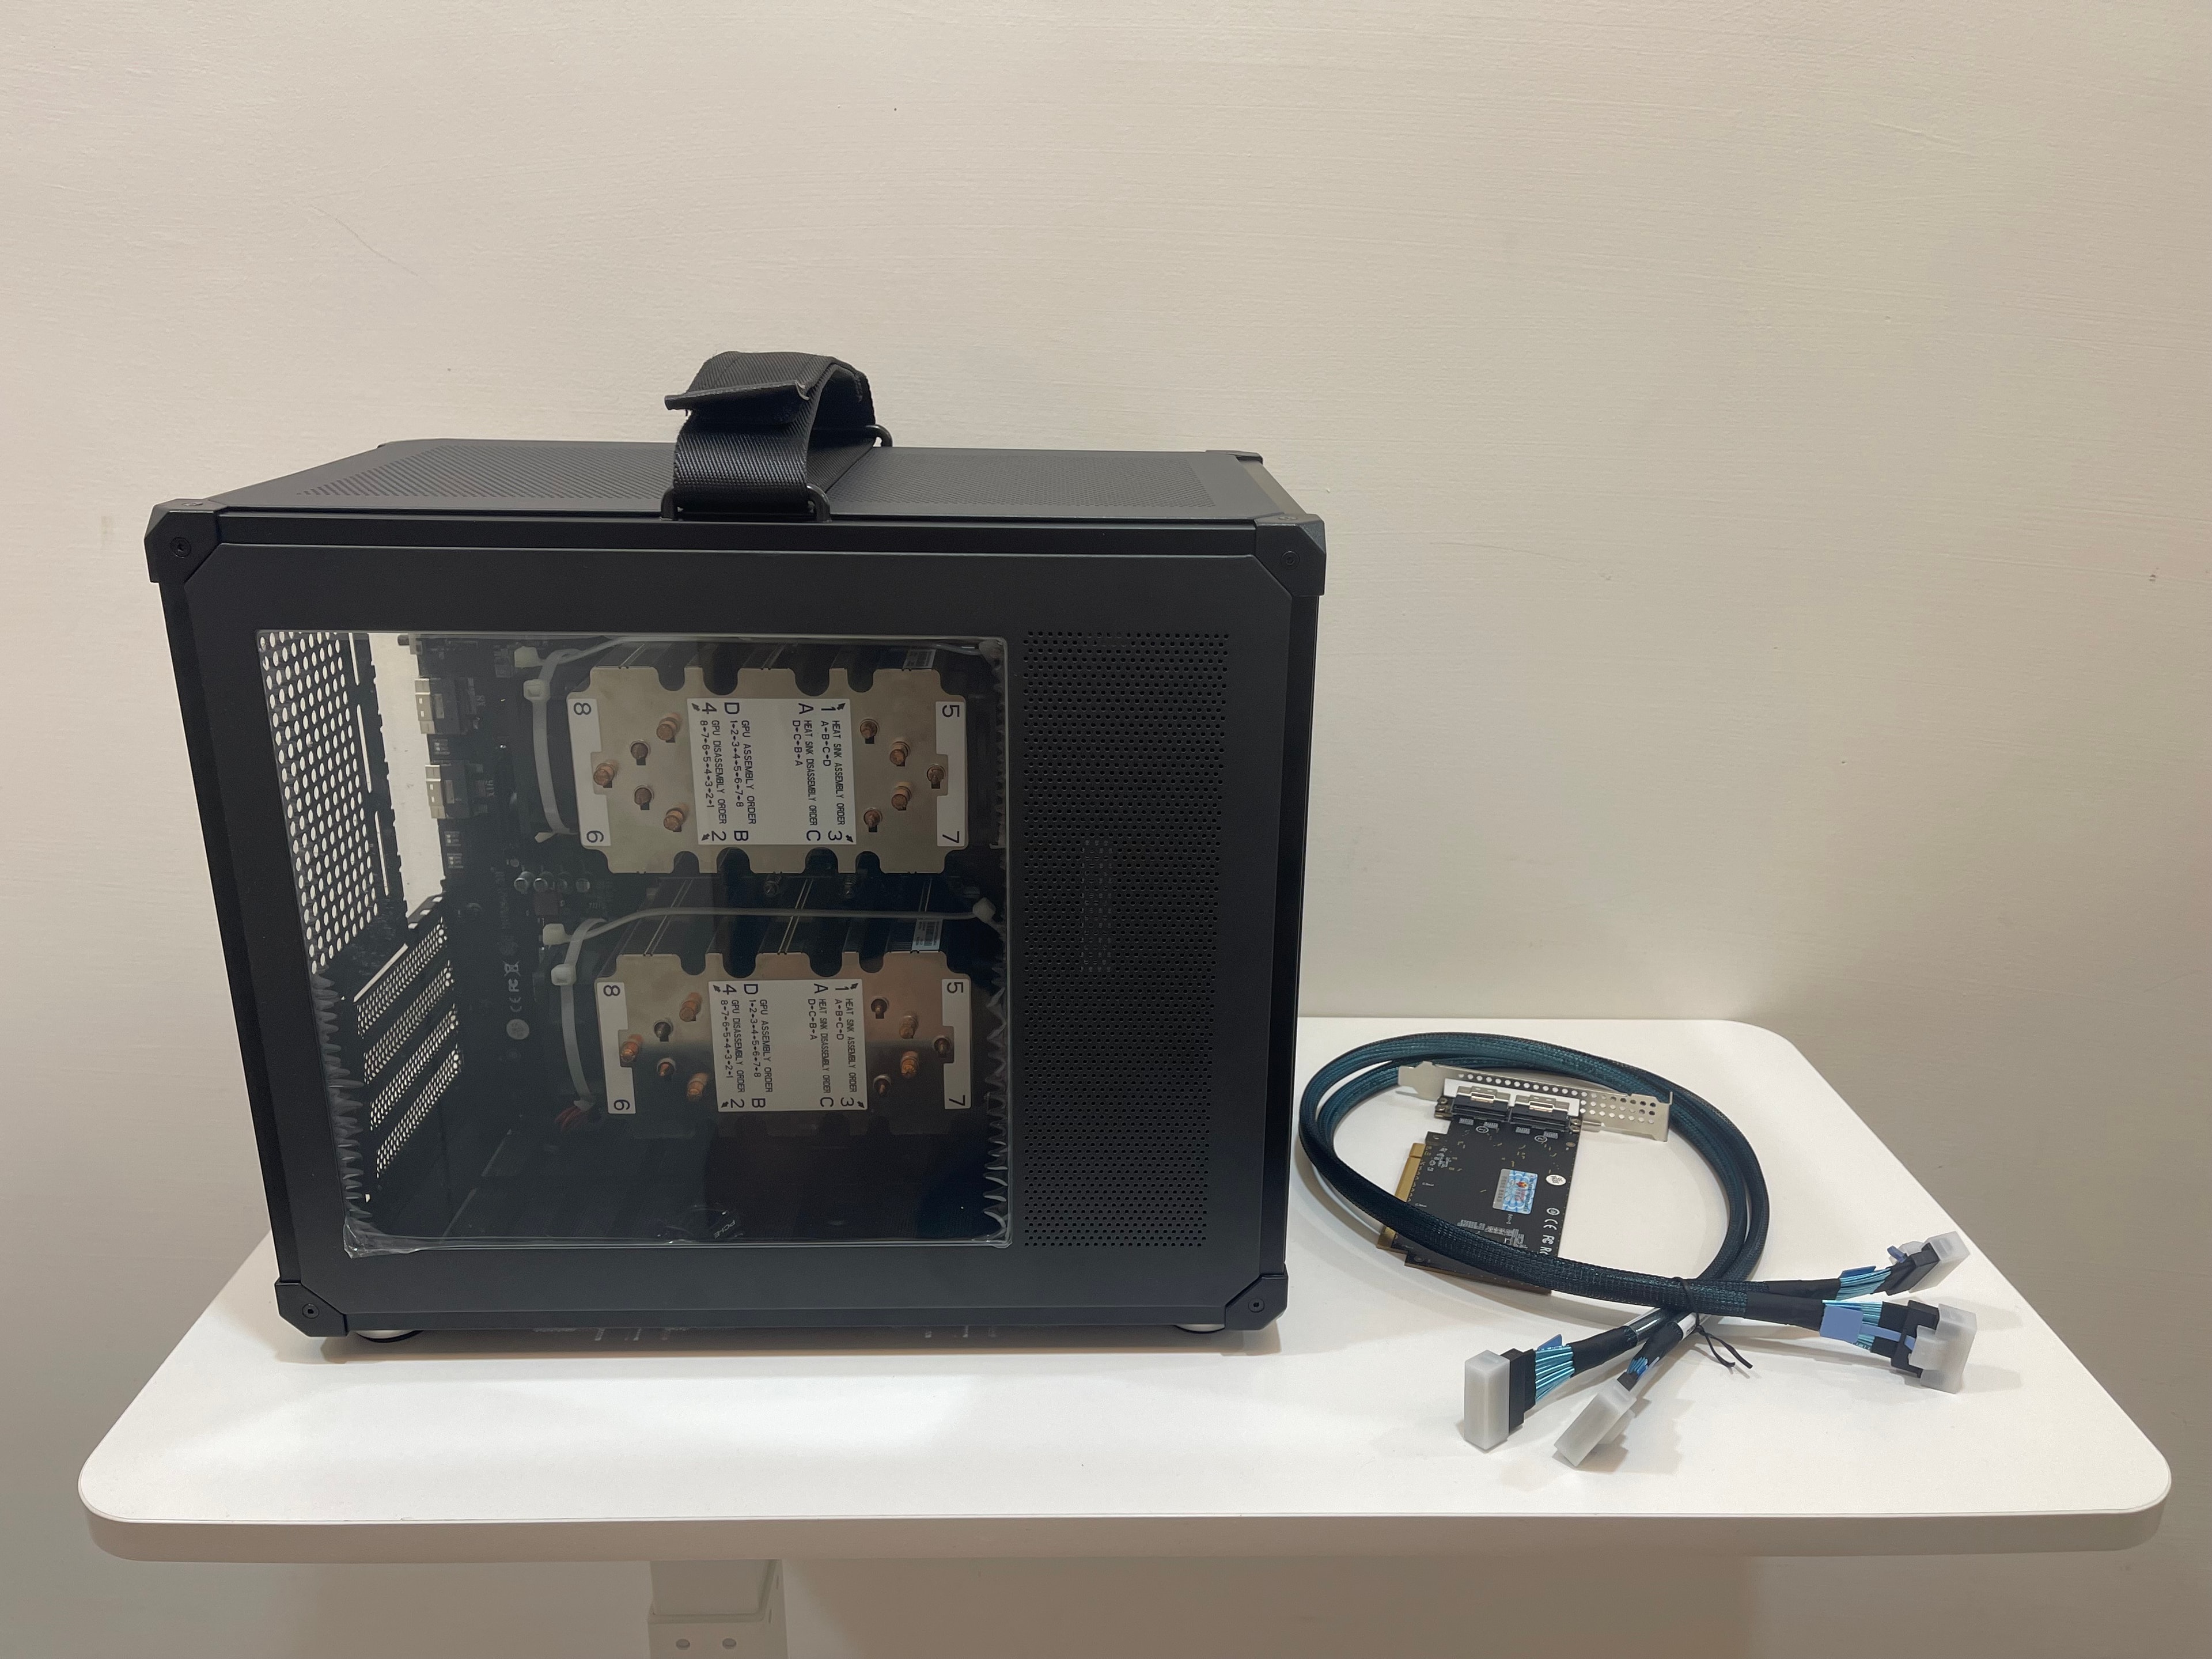
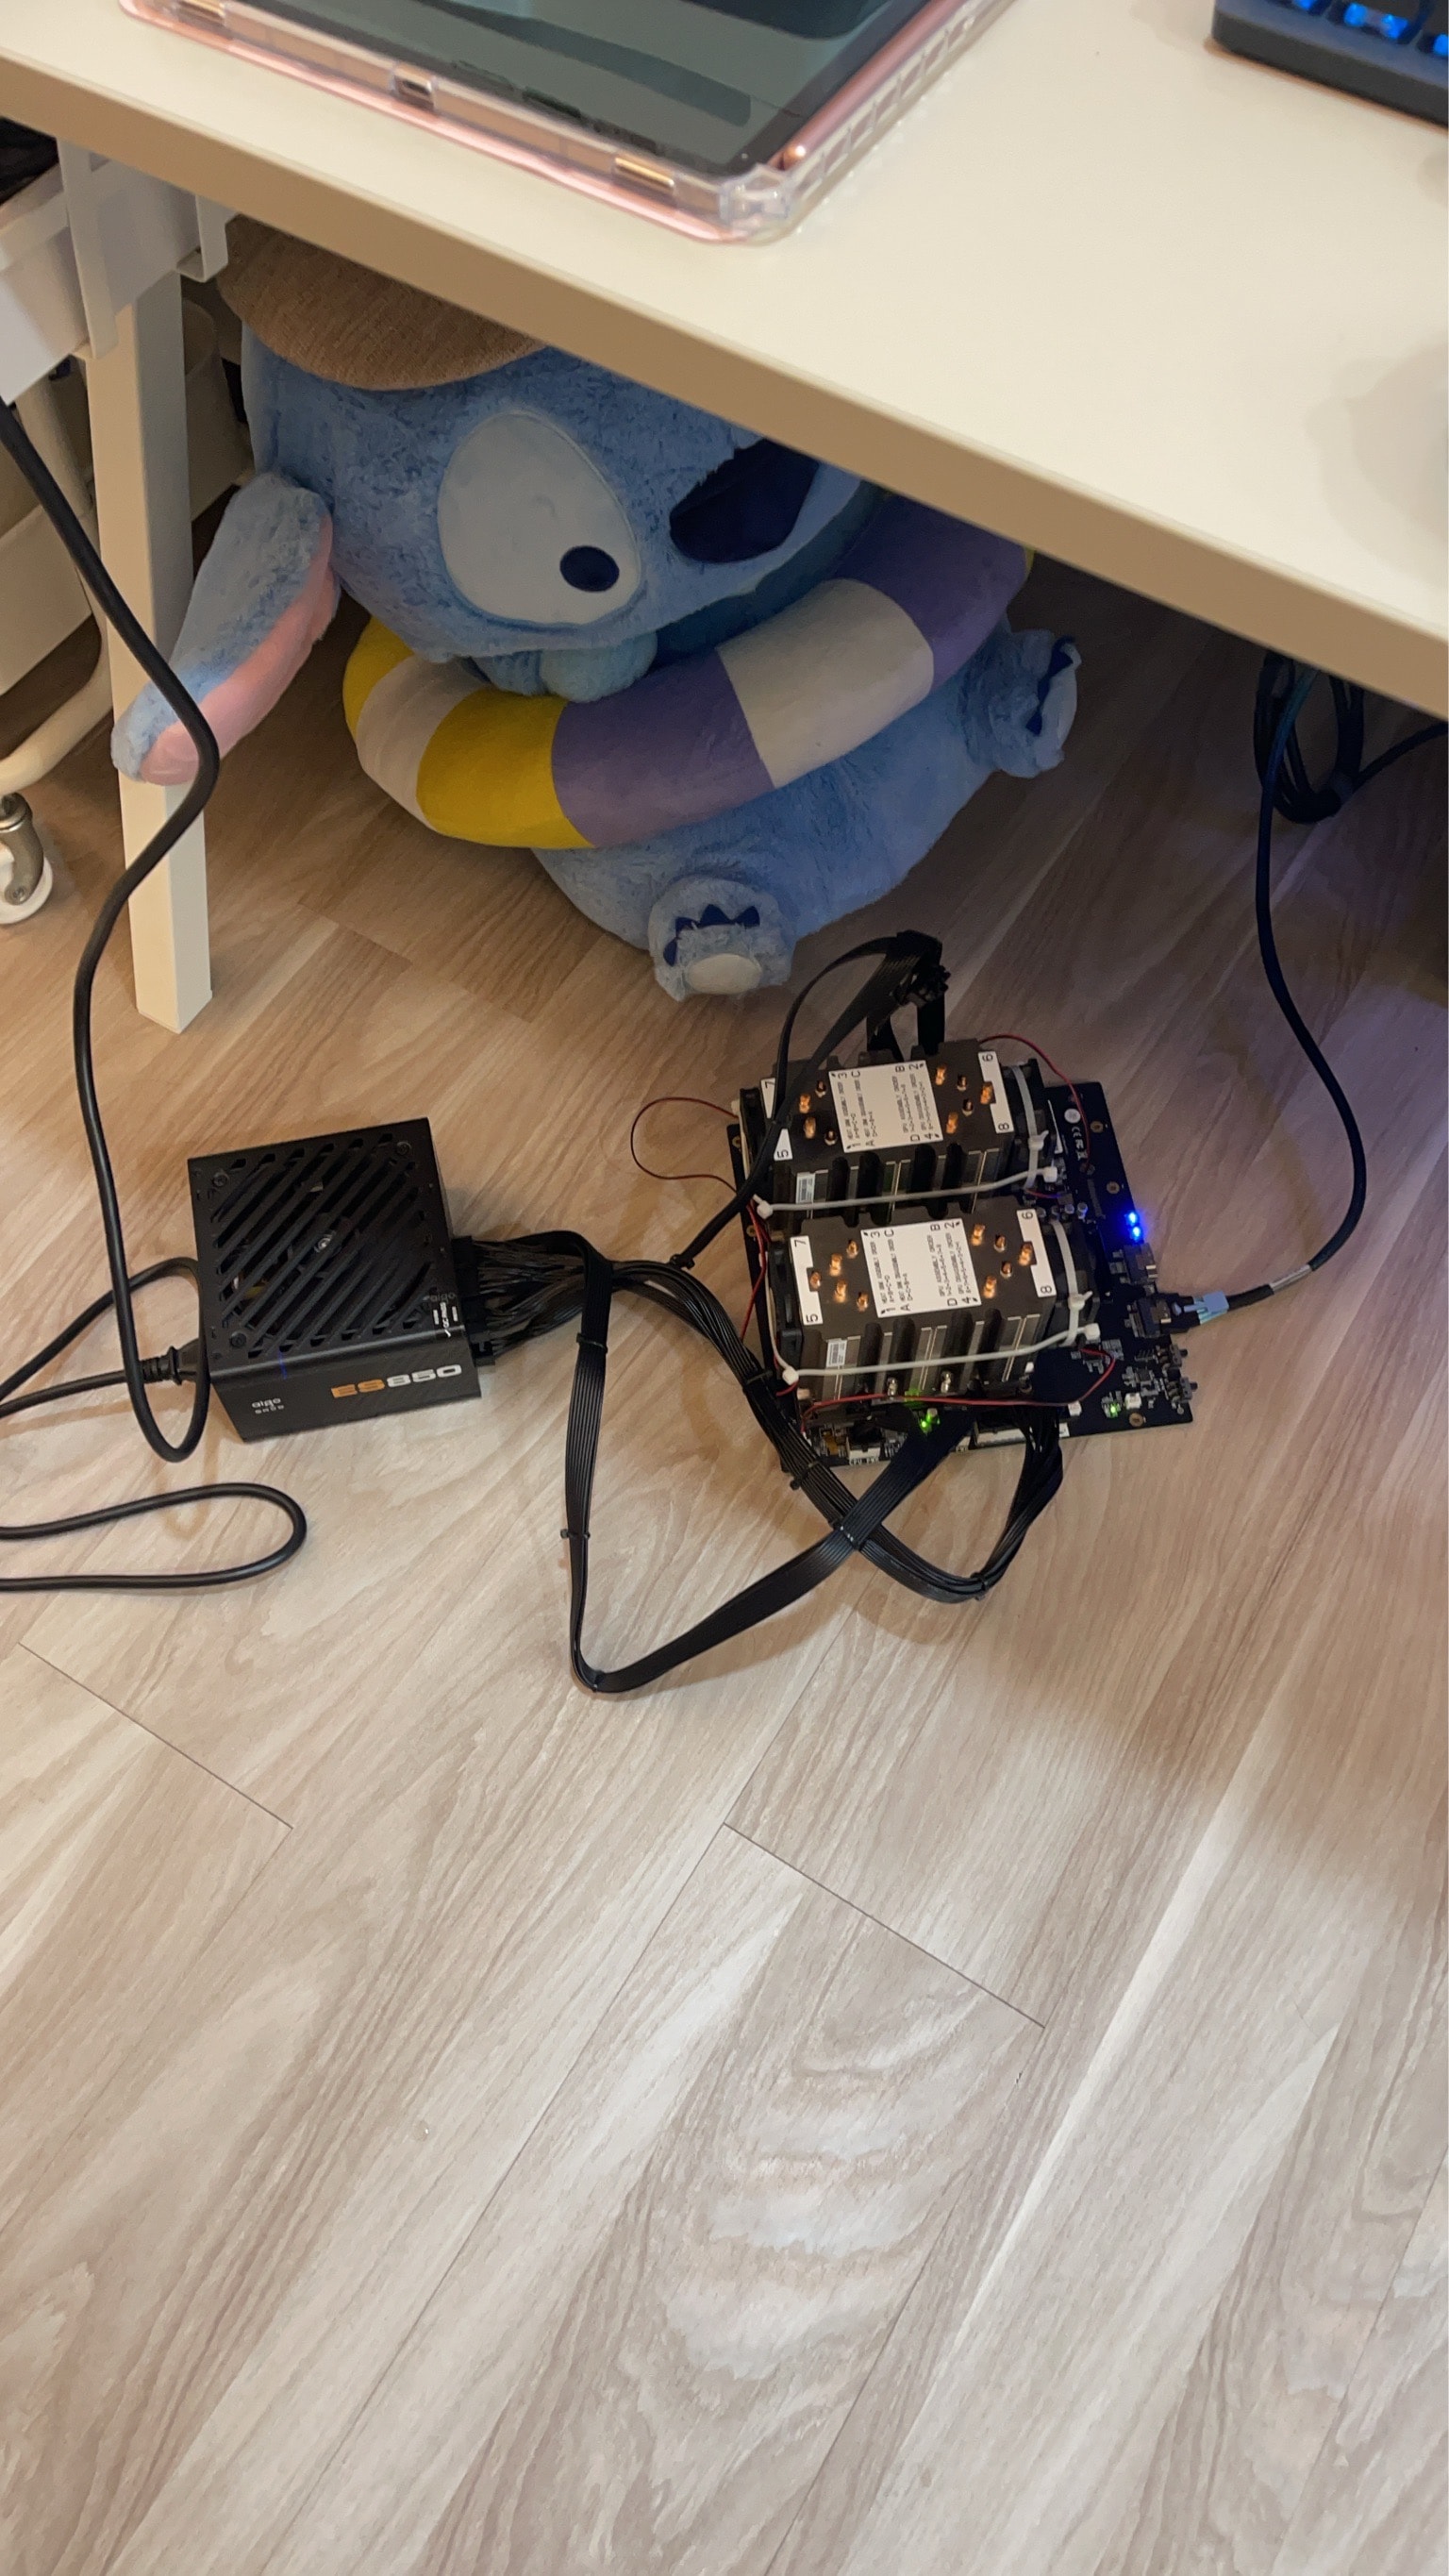
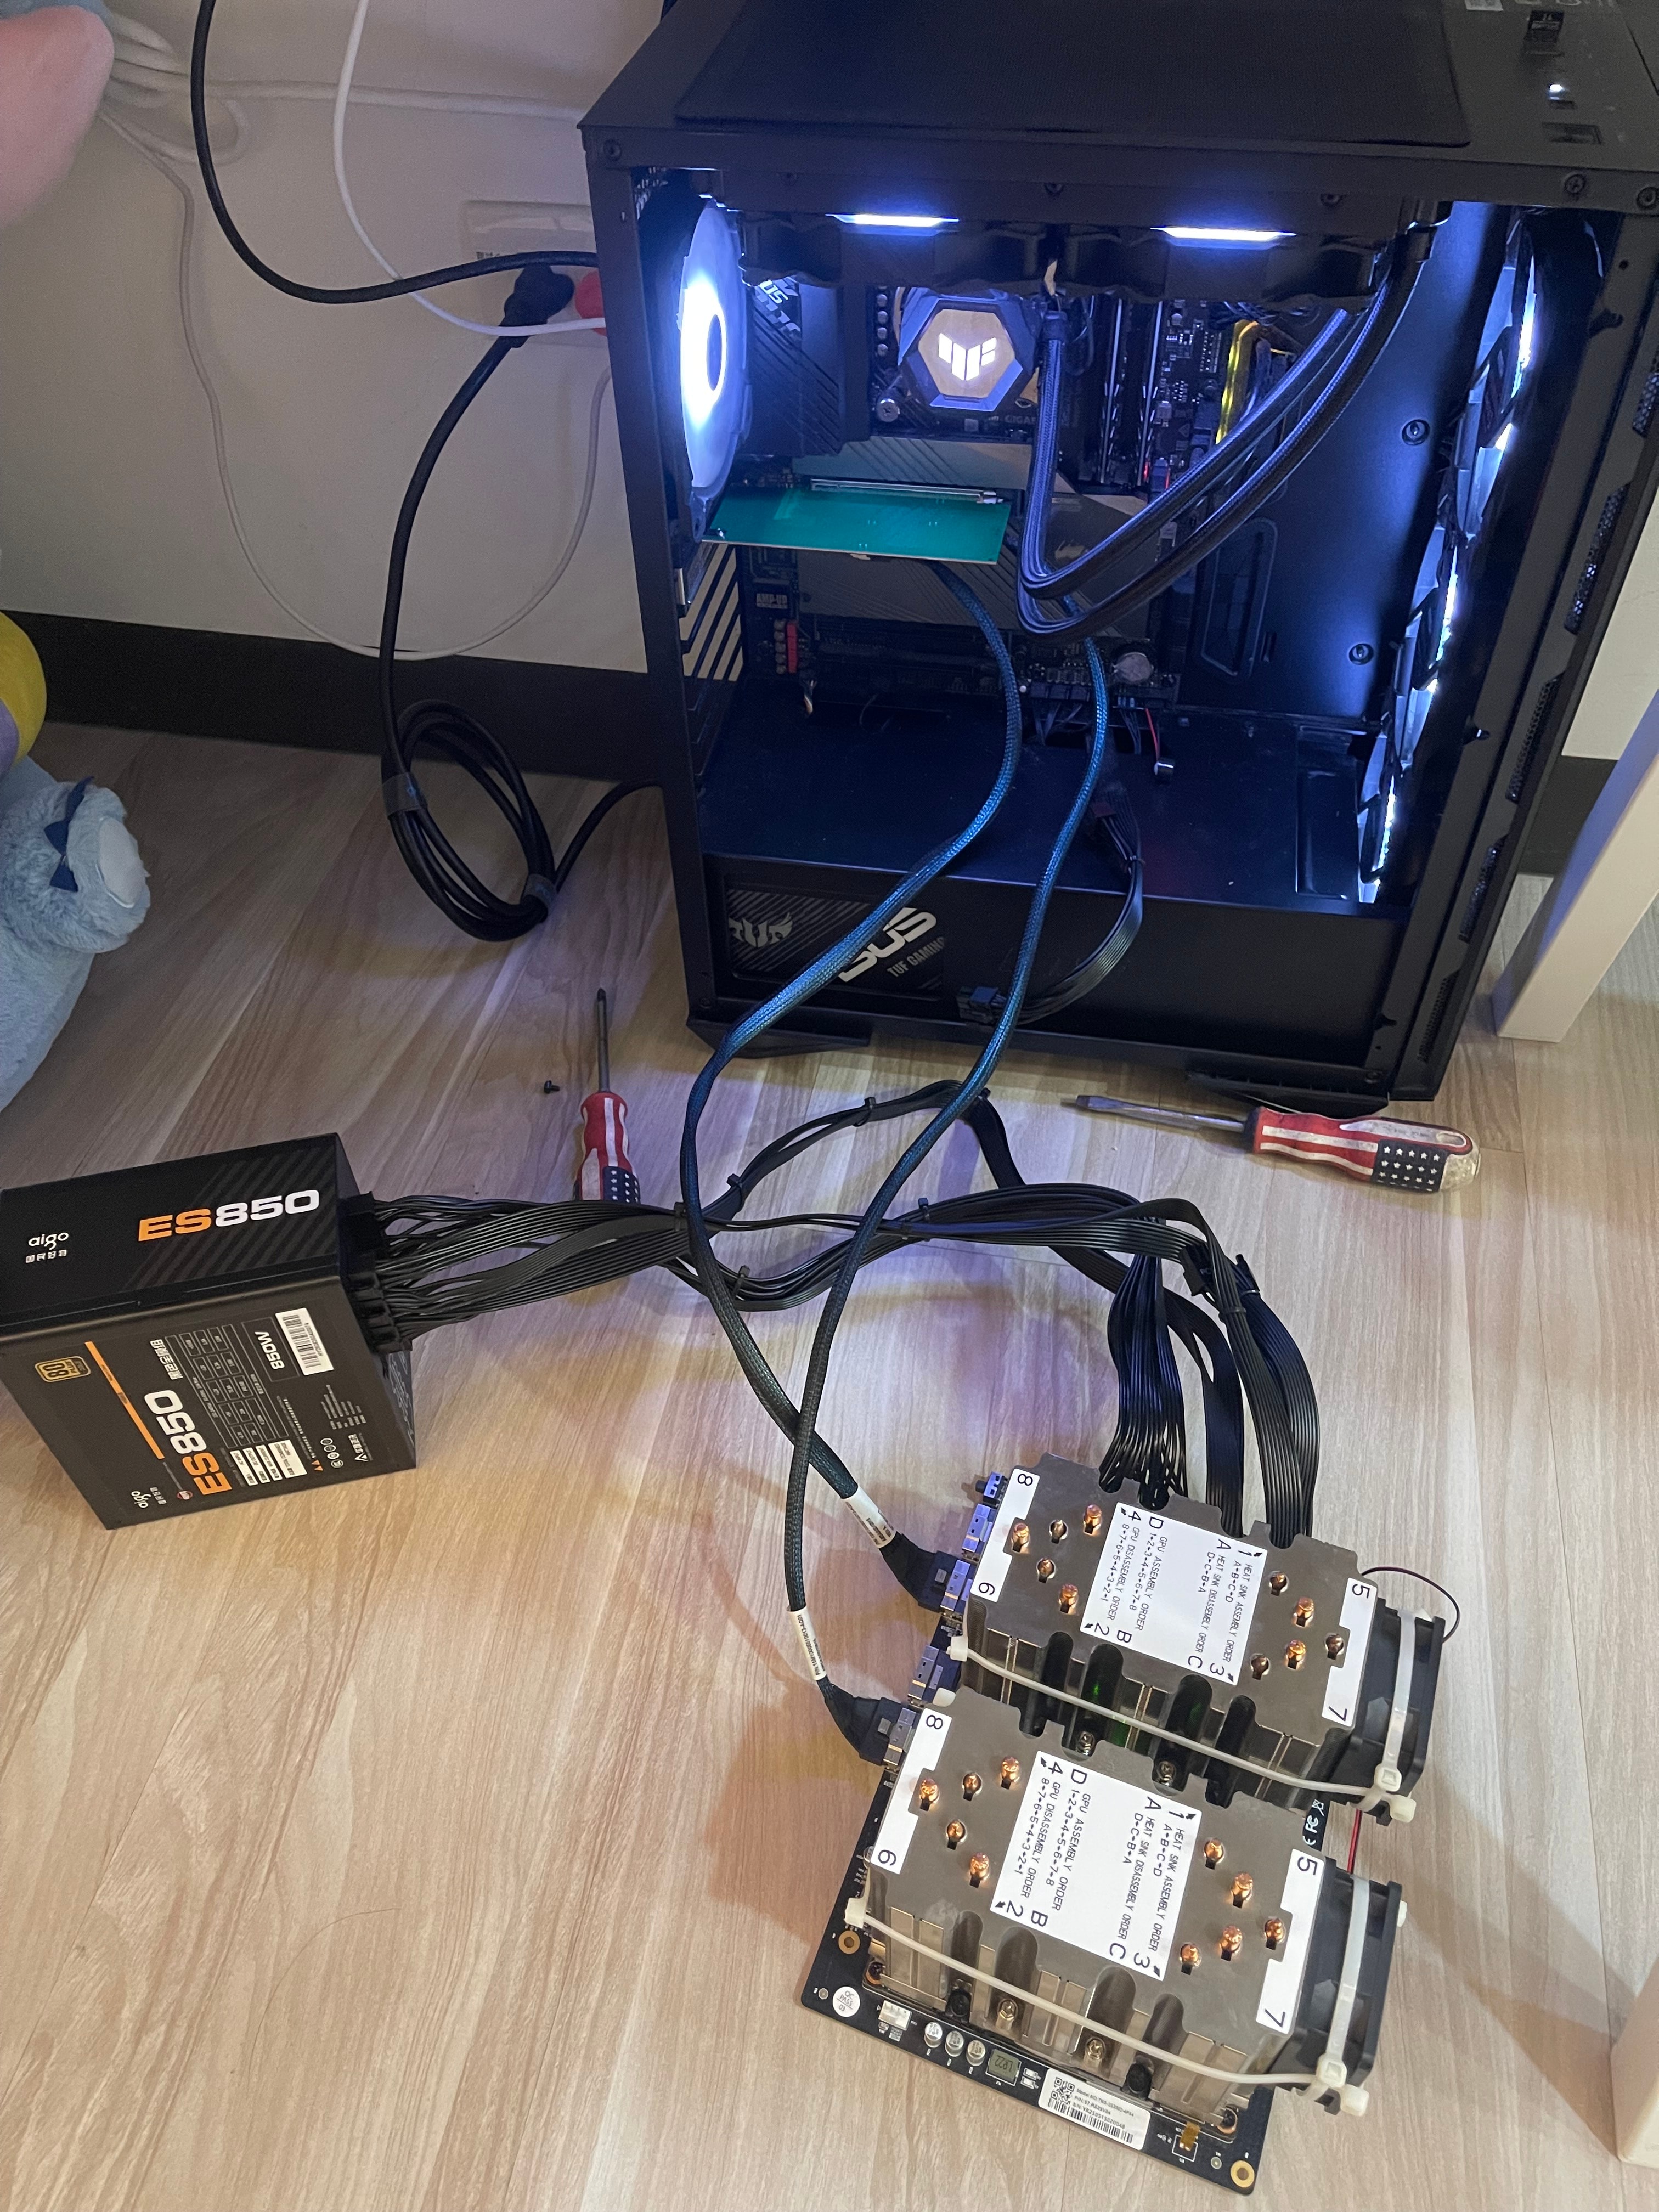
哈囉各位,我最近在折騰 AI 本地部署,意外發現一張「神卡」組合,效果真的不錯,想跟大家分享。
今年五月,我通過了 U-start 創業計畫,主要在做「永續報告書專用 AI 模型」的開發。
在執行計畫過程中,遇到一個很大的痛點:
台灣高階顯卡取得困難
租用價格過高
科研用的卡甚至有錢也買不到
於是我們團隊開始研究,能不能找到更便宜的算力來源。
最後,我們鎖定了一張神卡: Tesla V100 SXM2。
這張卡效能強大,但缺點是:
接口協議特殊
入門門檻高(需要找渠道、零件、組裝、驅動安裝…)
經過一個多月研究與測試,我們團隊已經成功把 V100 改造成 小巧輕便、PCIe 接口隨插即用的套裝,
不用再受限於伺服器環境,一般電腦就能輕鬆使用。
現在,它不只是科研卡,更是人人可親近的高性價比 GPU 解決方案。
📌規格與特色
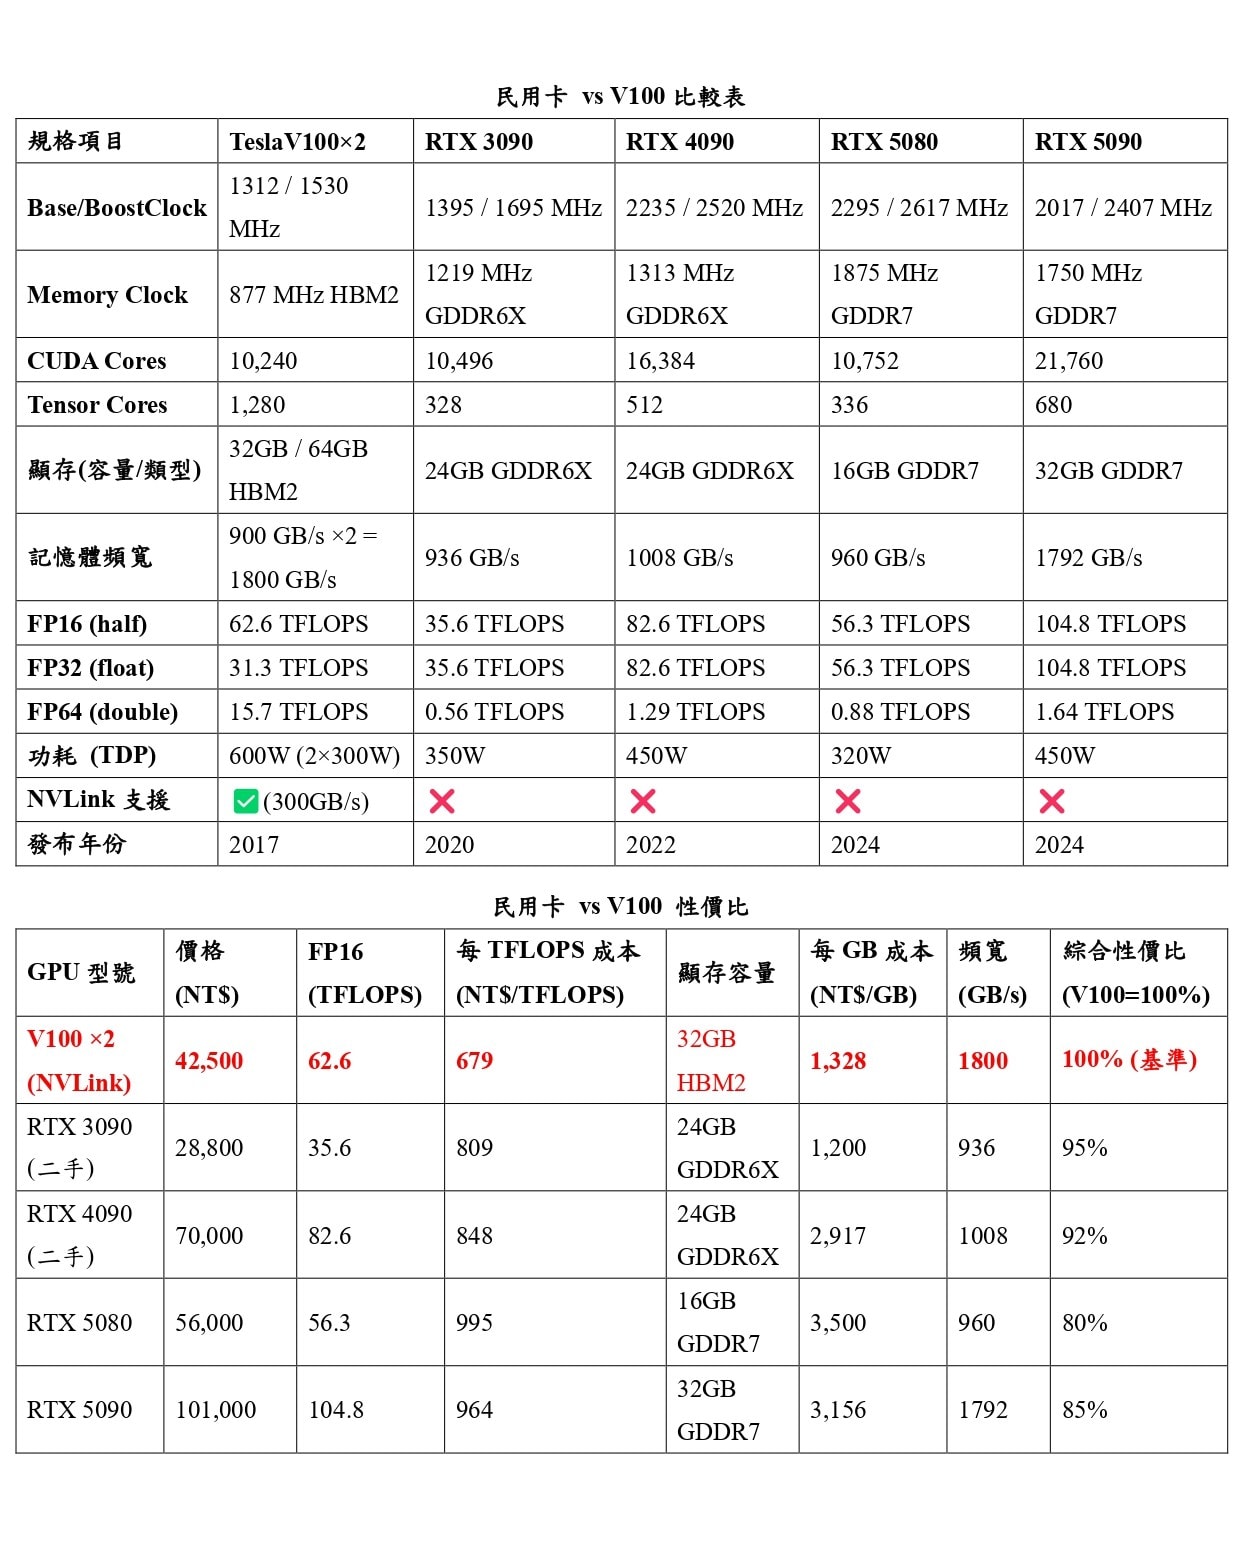
目前市面上顯卡的價格,往往與 CUDA 核心數、Tensor Core 數量以及顯存容量 緊密相關。
以我們測試的 Tesla V100 雙卡套裝為例:
運算核心:合計 10,240 CUDA Cores / 1,280 Tensor Cores
效能表現:在 AI 運算上,大致相當於 RTX 5080 等級
顯存規格:16GB ×2(總 32GB)32GB ×2(總 64GB)
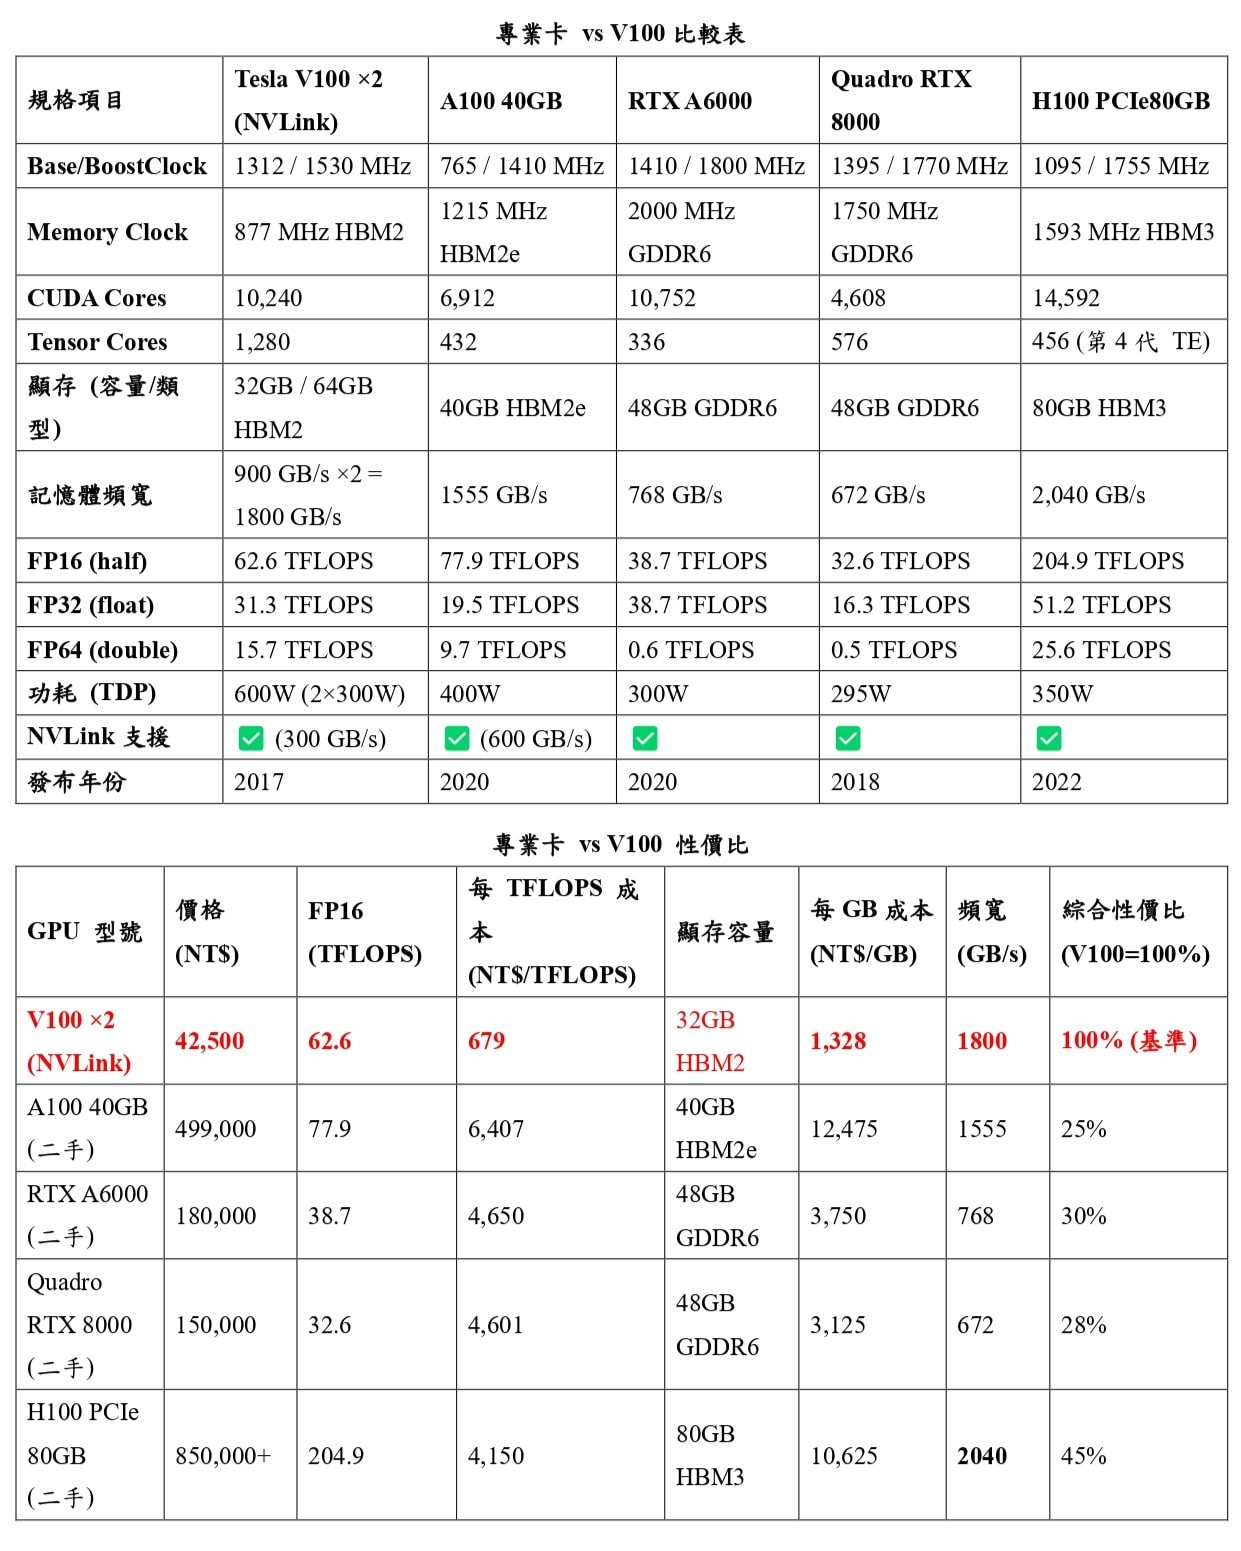
記憶體技術:搭載 伺服器等級 HBM2 高頻寬記憶體,雙卡頻寬最高可達 1,800 GB/s,遠超一般 GDDR 顯卡
性價比:在相近效能條件下,整體價格卻比同級顯卡更具優勢
💾實測數據
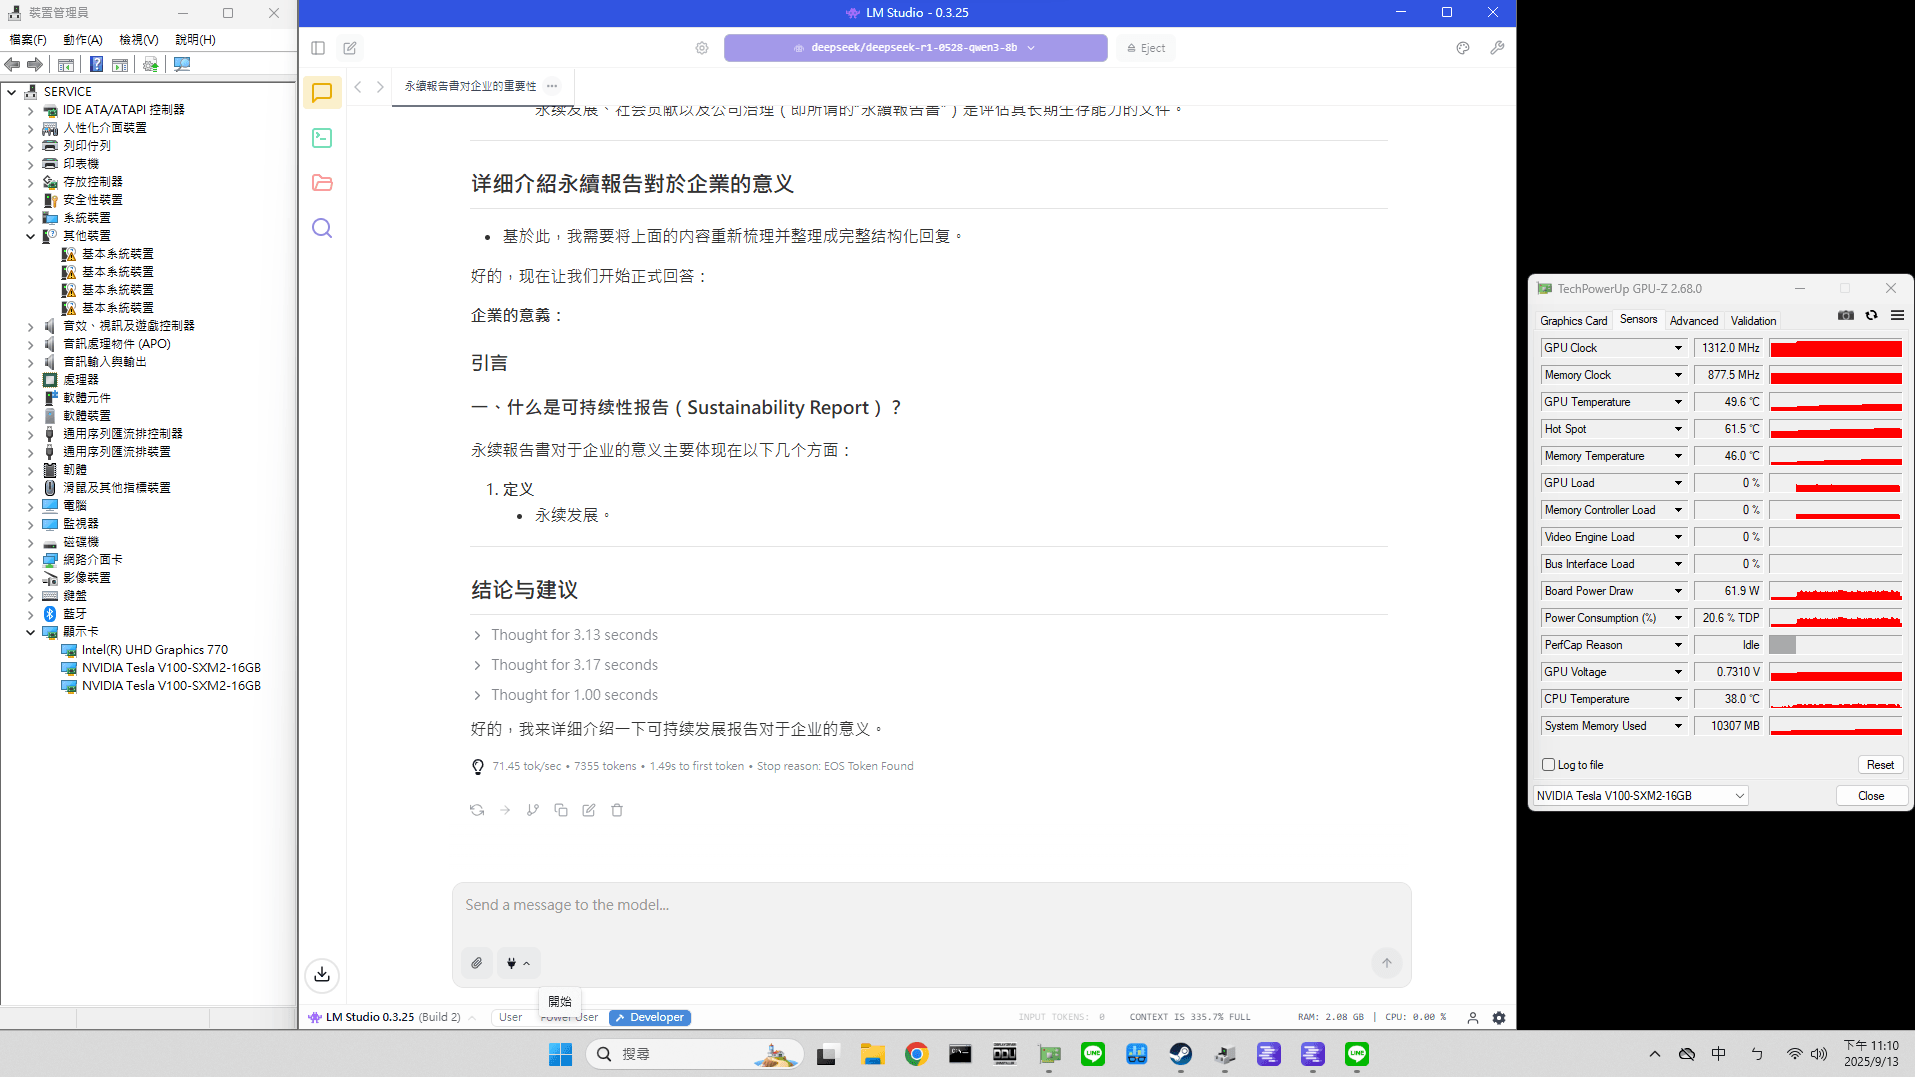
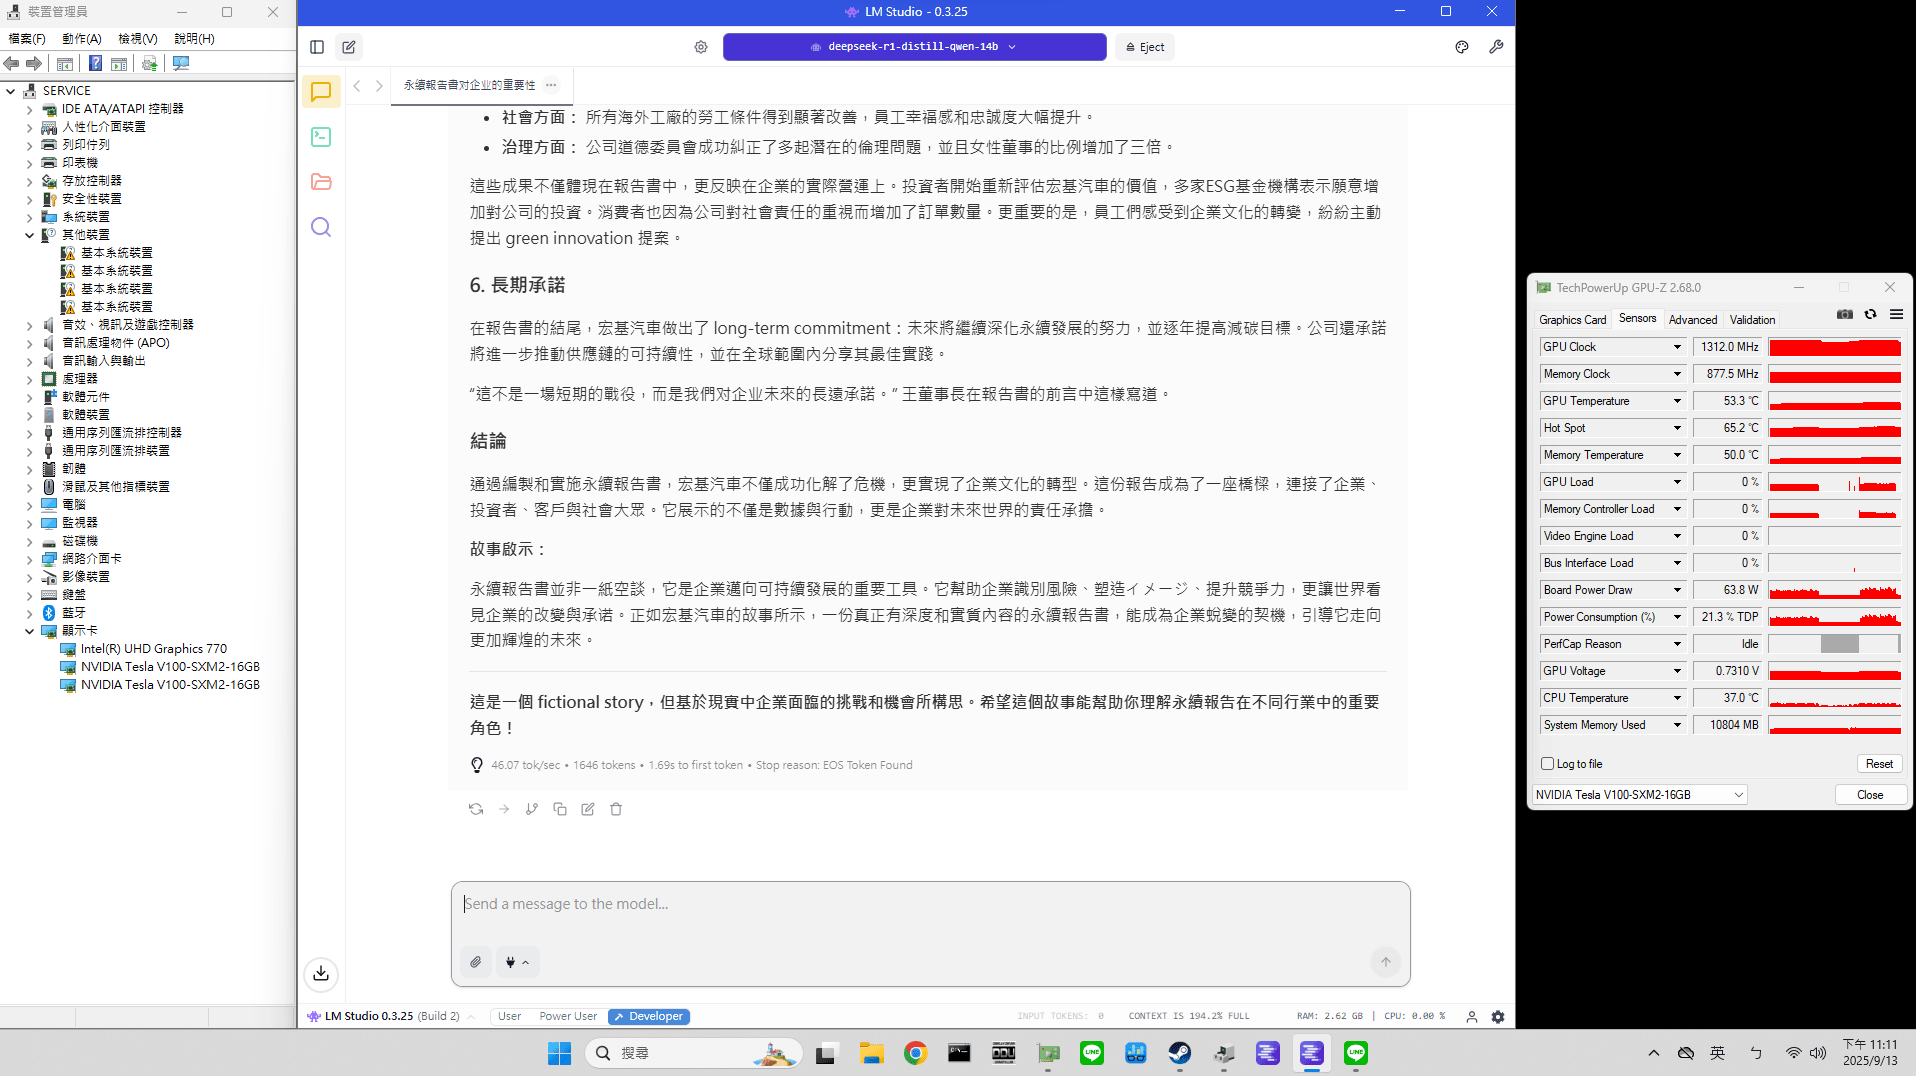
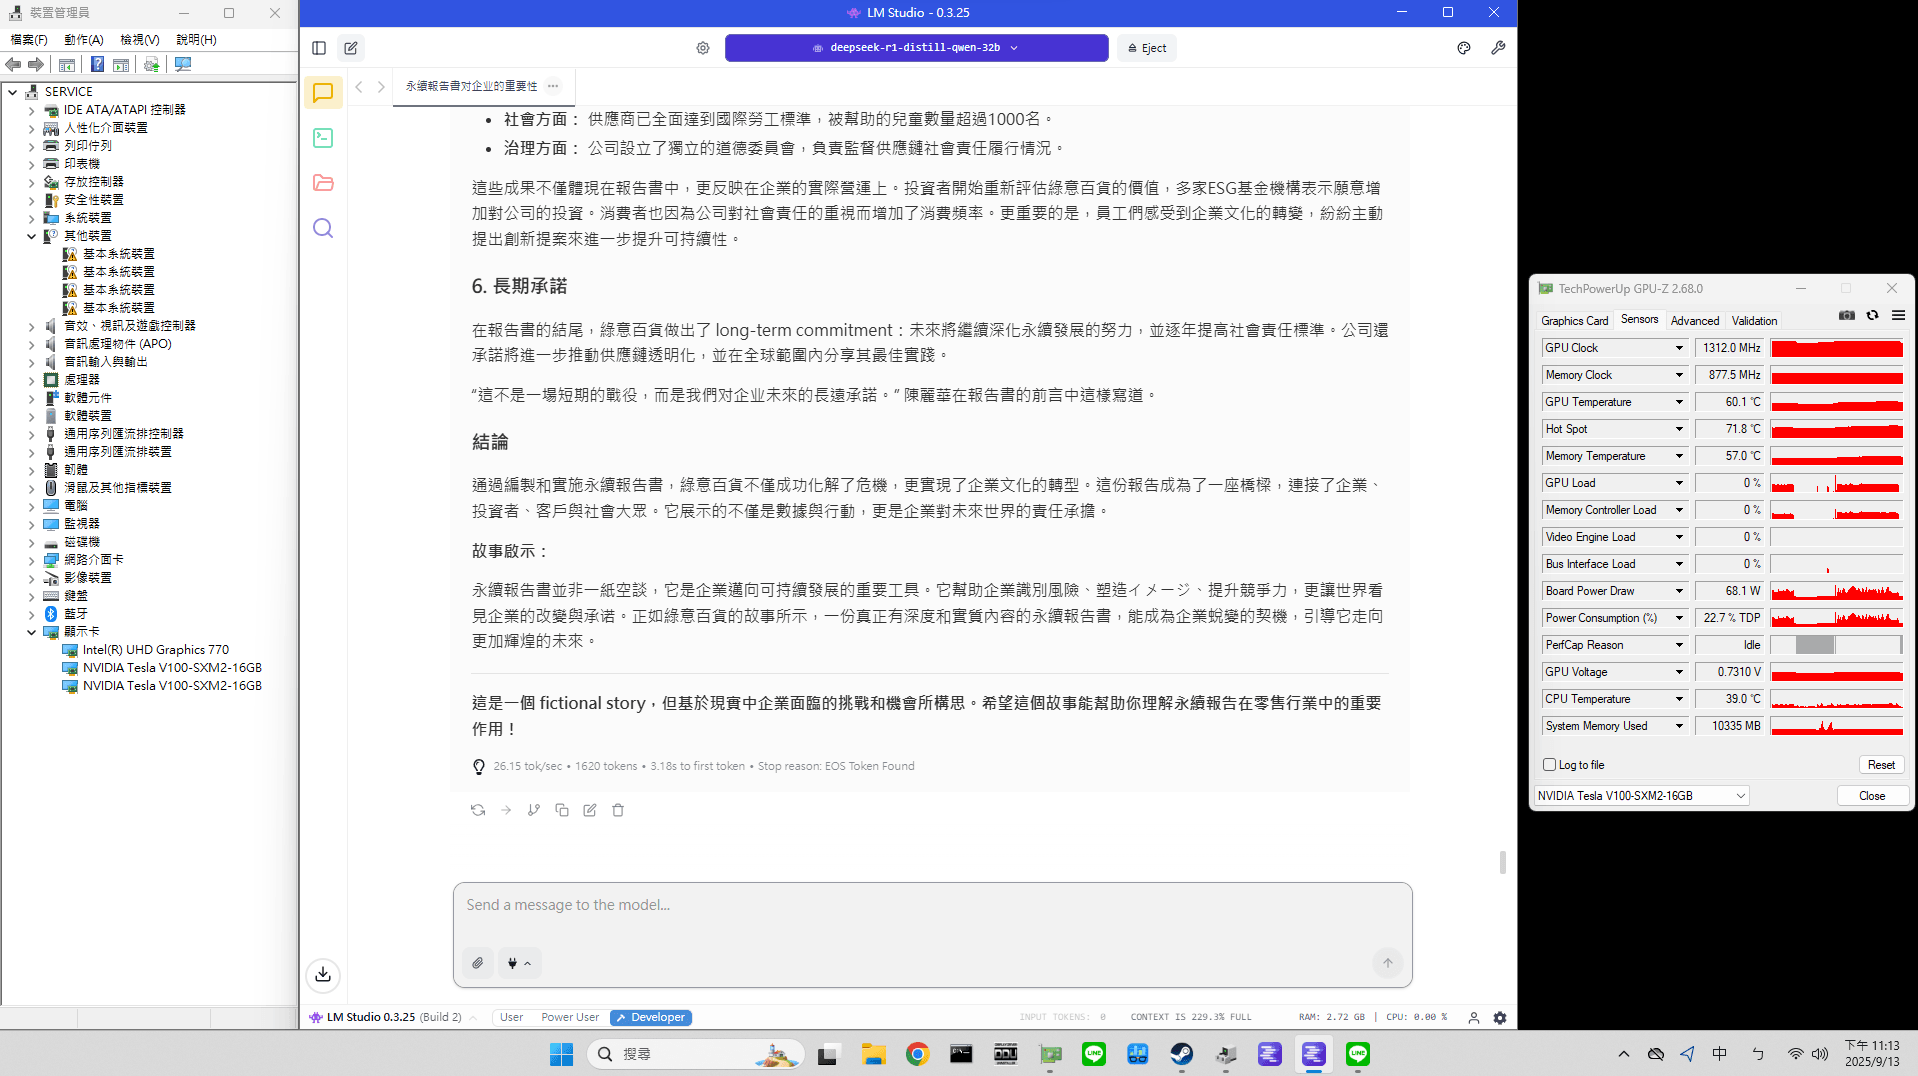
我們用 LM Studio 在 16GB ×2(總 32GB)套裝 進行實測,結果如下:
8B 模型:71.45 tok/s
14B 模型:46.07 tok/s
32B 模型:26.15 tok/s
這代表 16×2 套裝不僅能輕鬆應付中大型模型,
甚至在 32B 模型上依然能運行,對需要本地部署 AI 的朋友相當實用。
如果升級到 32GB ×2(總 64GB):
可更穩定地運行 超大型模型(65B/70B 級別)
可同時部署多個模型實例
更適合科研單位與高需求應用。
📦我們能提供的服務
正規公司身份
保固服務
無償教學安裝
客製化選配(電腦機殼外觀、電源供應器可挑選)
訂製方案(依需求調整配置,價格更具彈性)
🛒購買管道與聯繫方式
如果想要有保障的購買管道,我們也有蝦皮官方賣場:
CXTech官方旗艦店(支援信用卡、分期、蝦皮保障)
☎️聯繫方式:
蝦皮賣場:CXTech官方旗艦店
有興趣的朋友,歡迎私訊或透過以上方式交流。